SCFold · Research & Engineering
Kassenbon-OCR.
11 Modelle.
100 Bons.
Gleiche Belege. Gleiche Aufgabe. Unterschiedliche Antworten. Wir vergleichen lokale OCR-Modelle und Azure-Konfigurationen – vom erkannten Text bis zu nutzbaren Artikeldaten.
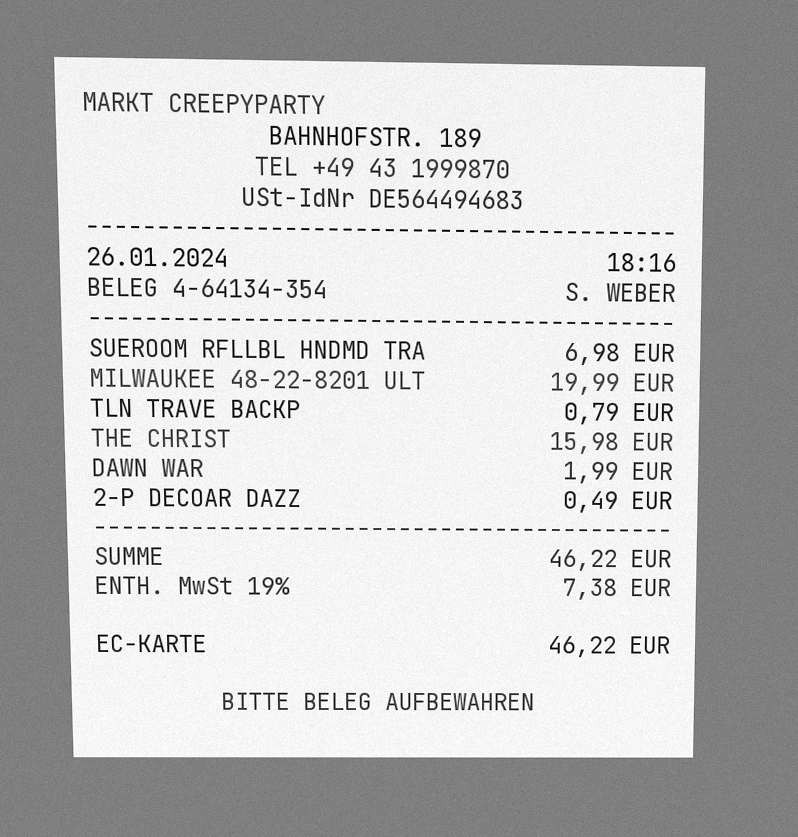
ORIGINALBON 01 / 100
GLM-OCR · DIESER BON
100 % Textgenauigkeit
REFERENZDATEN
total: 46.22 EUR
eval-000008 6 Referenzartikel
Höchste Zeichengenauigkeit
99,99 %
GLM-OCR · 4 Zeicheneditierfehler auf 34.624 Referenzzeichen.
Geringste geschätzte Cloud-Kosten
0,0121 USD
GPT-5 nano · für 100 Bons bei 97,64 % Zeichengenauigkeit.
Direkte Zeilensummen korrekt
481 / 482
Document Intelligence · native Felder, separat ausgewertet.
Das Wichtigste zuerst
Fast alle Zeichen.
Aber auch alle Daten?
Ein lesbarer Bon ist noch kein verlässlicher Datensatz. Deshalb betrachten wir mehr als die reine Texterkennung.
01
Text erkennen ist der Anfang.
GLM-OCR erreicht 99,9884 % Zeichengenauigkeit. Vollständig identisch sind 96 von 100 normalisierten Bontexten. Zeichen und ganze Dokumente brauchen eigene Kennzahlen.
02
Struktur verändert das Ergebnis.
GPT-5 nano erreicht 97,64 % Textgenauigkeit. Nach dem gemeinsamen Parser stimmen 69,96 % der Produktnamen. Eine gute Transkription allein reicht für Artikeldaten nicht aus.
03
API-Preis ist nicht Gesamtaufwand.
Die günstigste Cloud-Konfiguration kostet geschätzt 0,0121 USD je 100 Bons. Hardware, Betrieb und Nachbearbeitung gehören zur Entscheidung dazu.
Der interaktive Vergleich
Ihr Einsatz. Ihre Kriterien.
Wählen Sie Modelle, sortieren Sie die Ergebnisse und ändern Sie das Belegvolumen. Alle Kennzahlen beruhen auf denselben 100 Bons.
Modelle auswählen 11/11
Bitte eine ganze Zahl von 1 bis 1.000.000 eingeben.
| Modell | Zeichengenauigkeit | Produktnamen | Zeilensummen | Mengen | Bons exakt | Beobachtete ZeitØ s/Bon | API-Kosten100 Bons · USD |
|---|---|---|---|---|---|---|---|
| GLM-OCRLokal | 99,9884% | 94,81% | 95,41% | 12,97% | 96/100 | 5,96 | 0 |
| gpt-6.1-solAzure | 99,9336% | 92,43% | 95,02% | 12,95% | 81/100 | 6,58 | ≈ 0,339554 |
| gpt-5.6-solAzure | 99,8469% | 88,42% | 95,21% | 12,97% | 65/100 | 3,90 | ≈ 0,664284 |
| gpt-6-solAzure | 99,7661% | 87,03% | 94,61% | 12,97% | 63/100 | 3,32 | ≈ 0,331184 |
| gpt-5.6-terraAzure | 99,5754% | 88,84% | 94,42% | 12,95% | 65/100 | 2,72 | ≈ 0,370498 |
| mistral-ocr-4-0Azure | 98,7610% | 93,98% | 94,18% | 12,45% | 81/100 | 2,46 | ≈ 0,400000 |
| PP-OCRv6 MediumLokal | 98,5068% | 93,19% | 93,99% | 12,63% | 57/100 | 1,54 | 0 |
| Azure Document Intelligence · ReceiptAzure | 97,9610% | 92,76% | 93,36% | 12,27% | 38/100 | 4,48 | ≈ 1,000000 |
| gpt-5-nanoAzure | 97,6404% | 69,96% | 83,40% | 11,07% | 22/100 | 3,46 | ≈ 0,012068 |
| PaddleOCR-VL-1.6Lokal | 97,1609% | 80,11% | 81,78% | 10,41% | 24/100 | 14,91 | 0 |
| Phi-4-multimodal-instructAzure | 78,8066% | 9,84% | 12,70% | 1,02% | 7/100 | 13,90 | ≈ 0,016864 |
Skala: 0–100 %. Exakte Bons: von 100.
Kein Modell ausgewählt. Wählen Sie ein Modell oder stellen Sie den vollständigen Vergleich wieder her.
Kennzahlen, Kosten und Zeiten richtig lesen
OCR bewertet Zeichen, nicht fehlerfreie Dokumente. Die Feldquoten enthalten den gemeinsamen Parser; Zeilensummen sind Artikelbeträge, keine Bon-Gesamtsummen.
Schätzungen in USD aus gemessenem Verbrauch. Andere Bonmengen sind lineare Hochrechnungen. Lokale Modelle haben keine API-Gebühren; Hardware und Strom sind nicht eingerechnet.
Beobachtete Zeit je Bon; unterschiedliche Stromversorgung und Netzwerklatenz erlauben keinen kontrollierten Geschwindigkeitsrang.
Vom Beleg zum Ergebnis
Weniger abstrakt.
Mehr zum Anfassen.
Originalbild und echte Modellausgabe nebeneinander. Wechseln Sie Bon, Modell und Ausgabeformat, um die Unterschiede im Detail zu sehen.

Modellausgabe
- Händler
- Nicht geliefert
- Datum
- 26.01.2024
- Ausgabeartikel
- 6
- Bon-Gesamtsumme
- 46,22 EUR
Artikelfelder · gemeinsamer Parser
Position 1
ProduktnameSUEROOM RFLLBL HNDMD TRA✓ KorrektMenge—— Nicht geliefertReferenz: 1Einzelpreis—— Nicht geliefertReferenz: 6,98Zeilensumme6,98✓ KorrektPosition 2
ProduktnameMILWAUKEE 48-22-8201 ULT✓ KorrektMenge—— Nicht geliefertReferenz: 1Einzelpreis—— Nicht geliefertReferenz: 19,99Zeilensumme19,99✓ KorrektPosition 3
ProduktnameTLN TRAVE BACKP✓ KorrektMenge—— Nicht geliefertReferenz: 1Einzelpreis—— Nicht geliefertReferenz: 0,79Zeilensumme0,79✓ KorrektPosition 4
ProduktnameTHE CHRIST✓ KorrektMenge—— Nicht geliefertReferenz: 1Einzelpreis—— Nicht geliefertReferenz: 15,98Zeilensumme15,98✓ KorrektPosition 5
ProduktnameDAWN WAR✓ KorrektMenge—— Nicht geliefertReferenz: 1Einzelpreis—— Nicht geliefertReferenz: 1,99Zeilensumme1,99✓ KorrektPosition 6
Produktname2-P DECOAR DAZZ✓ KorrektMenge—— Nicht geliefertReferenz: 1Einzelpreis—— Nicht geliefertReferenz: 0,49Zeilensumme0,49✓ Korrekt
OCR-Text
MARKT CREEPYPARTY
BAHNHOFSTR. 189
TEL +49 43 1999870
USt-IdNr DE564494683

26.01.2024 18:16
BELEG 4-64134-354 S. WEBER

SUEROOM RFLLBL HNDMD TRA 6,98 EUR
MILWAUKEE 48-22-8201 ULT 19,99 EUR
TLN TRAVE BACKP 0,79 EUR
THE CHRIST 15,98 EUR
DAWN WAR 1,99 EUR
2-P DECOAR DAZZ 0,49 EUR

SUMME 46,22 EUR
ENTH. MwSt 19% 7,38 EUR

EC-KARTE 46,22 EUR

BITTE BELEG AUFBEWAHREN
Strukturierte Ausgabe (JSON)
{
    "store": null,
    "date": "26.01.2024",
    "currency": "EUR",
    "total": 46.22,
    "items": [
        {
            "name": "SUEROOM RFLLBL HNDMD TRA",
            "quantity": null,
            "unit": null,
            "unit_price": null,
            "line_total": 6.98,
            "source_line": "SUEROOM RFLLBL HNDMD TRA 6,98 EUR"
        },
        {
            "name": "MILWAUKEE 48-22-8201 ULT",
            "quantity": null,
            "unit": null,
            "unit_price": null,
            "line_total": 19.99,
            "source_line": "MILWAUKEE 48-22-8201 ULT 19,99 EUR"
        },
        {
            "name": "TLN TRAVE BACKP",
            "quantity": null,
            "unit": null,
            "unit_price": null,
            "line_total": 0.79,
            "source_line": "TLN TRAVE BACKP 0,79 EUR"
        },
        {
            "name": "THE CHRIST",
            "quantity": null,
            "unit": null,
            "unit_price": null,
            "line_total": 15.98,
            "source_line": "THE CHRIST 15,98 EUR"
        },
        {
            "name": "DAWN WAR",
            "quantity": null,
            "unit": null,
            "unit_price": null,
            "line_total": 1.99,
            "source_line": "DAWN WAR 1,99 EUR"
        },
        {
            "name": "2-P DECOAR DAZZ",
            "quantity": null,
            "unit": null,
            "unit_price": null,
            "line_total": 0.49,
            "source_line": "2-P DECOAR DAZZ 0,49 EUR"
        }
    ]
}- Zeichengenauigkeit
- 100,0000 %
- Geschätzte API-Kosten
- 0 USD
OCR + gemeinsamer Parser · GLM-OCR
Die interaktiven Daten konnten nicht geladen werden. Wählen Sie Bon und Modelle und nutzen Sie „Vergleich anzeigen“.
Die ersten zehn Bons in Datensatzreihenfolge · Bilder unverändert · synthetic-receipts-ocr · Apache 2.0
Die Einordnung
Die richtige Zahl
für die richtige Aufgabe.
Ein Spitzenwert beantwortet noch nicht, welches Modell zu Ihrem Prozess passt.
01 / VOLLTEXT
Suchen und wiederfinden.
Prüfen Sie Zeichengenauigkeit, vollständig richtige Texte und schwierige Belegtypen. In dieser Stichprobe führt GLM-OCR beim Text.
02 / ARTIKELDATEN
Prüfen und übernehmen.
Prüfen Sie Artikel, Menge und Preis getrennt. Document Intelligence erkennt nativ 481 von 482 Zeilensummen; viele Mengen bleiben unerkannt.
Transparent getestet
Keine Blackbox.
Eine klare Methode.
Datensatz, Normalisierung, Konfiguration und Grenzen: So lassen sich die Ergebnisse nachvollziehen.
Welche Belege wurden verwendet?
Die ersten 100 deutschen Beispiele aus dem eval-Split von synthetic-receipts-ocr, in ursprünglicher Reihenfolge und in der Variante image_photo: 482 Referenzartikel, 34.624 normalisierte Zeichen. Alle elf Konfigurationen lieferten je 100 erfolgreiche Antworten.
Identische Eingaben und feste Konfigurationen
Alle Modelle erhalten dieselben PNG-Dateien nach EXIF-Drehung, RGB-Konvertierung und proportionaler Begrenzung auf 1.003.520 Pixel. Es gibt kein Deskew oder Unwarping. Die lokale Ausführung erfolgt auf einer NVIDIA GeForce RTX 3070 Ti Laptop GPU mit 8 GiB VRAM. Ein Warm-up je lokalem Modell wird nicht gewertet.
Chatmodelle erhalten einen festen Transkriptionsprompt, detail=high und höchstens 3.072 Ausgabetoken einschließlich eventueller Reasoning-Token. GPT-6.1 Sol nutzt low, GPT-5 nano minimal, die anderen getesteten Sol-/Terra-Konfigurationen none. Mistral verwendet seine native OCR-API; Document Intelligence verwendet prebuilt-receipt, API-Version 2024-11-30.
Was Zeichengenauigkeit und Feldquoten messen
Der Textvergleich vereinheitlicht Groß-/Kleinschreibung und Leerraum und entfernt reine Trennlinien. Die Zeichengenauigkeit ist max(0; 100 − 100 × Zeicheneditierfehler / Referenzzeichen), über alle Bons gemeinsam gewichtet. „Bons exakt“ verlangt einen vollständig identischen normalisierten Text.
Artikel werden global eindeutig nach Namensähnlichkeit zugeordnet (Hungarian-Verfahren, SequenceMatcher ≥ 0,45). Danach müssen Namen exakt normalisiert übereinstimmen; Zahlen dürfen weniger als 0,005 abweichen. Der Nenner pro Bon ist das Maximum aus Referenz- und Ausgabeartikelzahl. Fehlende Werte werden nicht als korrekt gezählt.
API-Kosten: gemessener Verbrauch, geschätzter Preis
Für Tokenmodelle werden Eingabe-, Cache- und Ausgabetoken mit den dokumentierten Referenztarifen multipliziert. Reasoning-Token sind bereits Teil der Ausgabe und werden nicht doppelt berechnet. Native OCR-Dienste werden pro Seite gerechnet; ein Testbon entspricht einer Seite.
Der Vergleich verwendet die im Bericht am 16. Oktober 2026 festgehaltenen Tarife. Die Beträge sind Verbrauchsschätzungen und keine Azure-Rechnung. Rabatte, Guthaben, Freikontingente, Steuern, feste Bereitstellungen und Vorabproben sind nicht enthalten. Bei lokalen Modellen bedeutet 0 USD ausschließlich: keine API-Gebühren. Hardware, Energie und Betrieb bleiben außerhalb dieser Rechnung.
Warum die Laufzeiten keine Geschwindigkeitsrangliste sind
PP-OCRv6 und die ersten drei PaddleOCR-VL-Bons liefen vor dem Anschluss des Laptop-Netzteils; der vierte Paddle-Bon lag im Übergang. GLM-OCR lief danach. Die lokalen Zeiten enthalten kein Modellladen. API-Zeiten enthalten Netzwerk, Warteschlange und mögliche Wiederholungen, bei Document Intelligence zusätzlich Statusabfragen.
Unterschiedliche Leistungszustände und Messzeitpunkte verhindern einen kontrollierten Geschwindigkeitsvergleich. Pro Konfiguration liegt ein Durchlauf vor. Bis zu zwei parallele API-Aufrufe waren konfiguriert; die angegebenen Werte sind Antwortzeiten einzelner Bons und keine Messung des Stapeldurchsatzes.
Datenstand und Reproduzierbarkeit
Dataset-Revision: ed46e02b9b1136f6b54847c1d4bce9e94d11e55c. Laufkennung: azure-d1a40be654e0b2d5. Der JSON-Download enthält alle 1.100 Einzelwertungen, Bild-Hashes, Modellkonfigurationen und Referenztarife. Vollständige API-Rohantworten und Bilder gehören nicht zu diesem Kennzahlenexport.
Der PDF-Bericht enthält die Kennzahlen als JSON-/CSV-Anlagen und protokollierte lokale Modellumgebungen. Cloud-Deploymentnamen dokumentieren die getestete Konfiguration; sie garantieren keine identische spätere Modellversion.
Wie gut sind die nativen Artikelfelder?
Azure Document Intelligence liefert zusätzlich strukturierte Felder mit prebuilt-receipt. Diese Ausgabe wurde getrennt vom gemeinsamen Regelparser ausgewertet.
| Artikelfeld | OCR + Regelparser | Direkte API-Felder |
|---|---|---|
| Produktname | 92,76 % | 98,34 % |
| Zeilensumme | 93,36 % | 99,79 % |
| Menge | 12,27 % | 13,28 % |
474 Produktnamen und 481 Zeilensummen sind korrekt. Mengen und Einzelpreise stimmen jeweils bei 64 von 482 Positionen. Nicht gelieferte Werte bleiben null. Optimierte JSON-Prompts anderer Modelle wurden hier nicht untersucht.
Wo liegen die Grenzen der Untersuchung?
100 synthetische Bons sind eine überschaubare Stichprobe. Reale Belege können zusätzliche Falten, schwachen Thermodruck, Rabatte und andere Layouts enthalten. Ein Vorwissen der Modelle über den öffentlichen Datensatz lässt sich nicht ausschließen.
Die Ergebnisse sind deskriptiv. Pro Konfiguration liegt ein Durchlauf vor; Wiederholungsläufe, Konfidenzintervalle und Signifikanztests fehlen. Für die Praxis folgt ein Test mit eigenen, manuell geprüften Belegen und den tatsächlich benötigten Feldern.
Eigene Untersuchung für SCFold vom 16. Oktober 2026. Kennzahlen und Referenztarife: vollständiger JSON-Export. Datensatz in der verwendeten Revision (Apache 2.0).
Vom Benchmark in Ihren Prozess
Dokumente verstehen.
Prozesse weiterdenken.
Sie möchten Belege automatisieren oder Document AI in Ihre Systeme integrieren? Beschreiben Sie uns Ihre Anwendung.